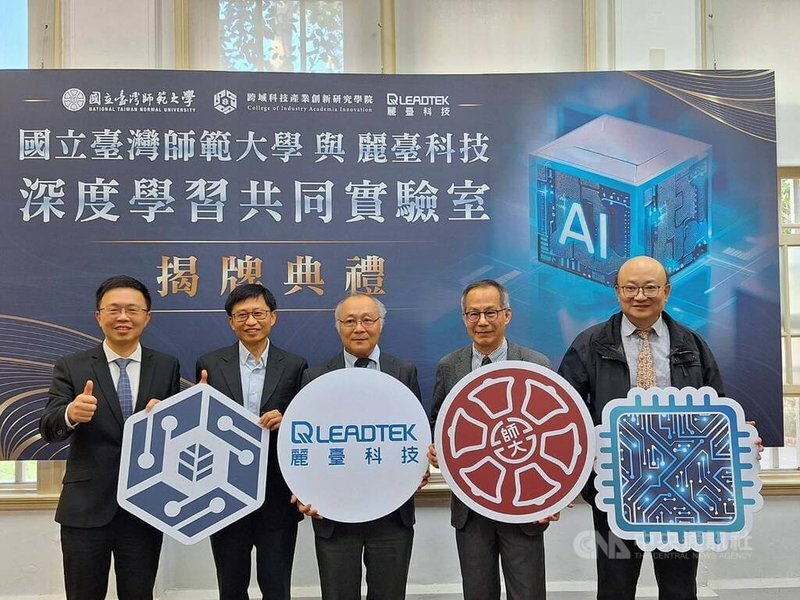
台灣師範大學最近宣布成立核心計算資源中心,投入地端AI建設,國科會補助三年六千萬元,學校另編列五千萬元,合計一億一千萬元。校方強調,未公開研究成果、個資、人事及財務資料都留在校內處理,避免使用商業AI造成機密外洩。這項計畫立意良善,也反映大學對AI自主與資訊安全的重視。
值得追問的是,如果每所大學、每家企業都爭相建立自己的AI伺服器,究竟是提升台灣的AI競爭力,還是製造另一場昂貴的資源浪費?
自己的AI成本高維護難
地端AI(On-Premises AI)確實有其必要,醫院的病歷、銀行的客戶資料、企業的營業秘密,以及大學尚未發表的研究成果,都不能毫無限制地送往外部平台。但資料必須受到保護,不代表每個機構都得購買GPU、建立機房、訓練自己的大型語言模型。資料主權與設備所有權是兩回事,把兩者畫上等號,恐怕會讓台灣付出極高的代價。
首先是成本,建置AI伺服器,買設備只是開始。高階GPU耗電驚人,還需要散熱、冷卻、網路、儲存、備援及資安防護。機房的電費、水費、設備折舊與碳排放,都是長期負擔。學校申請到三年補助,第四年怎麼辦?設備故障誰來修?冷卻系統需要汰換,誰來編列預算?一套AI系統如果沒有十年的營運規畫,很可能三年風光,五年後成為昂貴的電子廢棄物。
更麻煩的是GPU更新速度,AI硬體技術日新月異,今天斥資數千萬元採購的設備,兩三年後可能在效能、記憶體容量與能源效率上都落後新產品。大學的採購程序動輒半年、一年,等到設備驗收,市場早已推出新一代產品。學校不可能每隔兩年就重新編列數千萬元,最後只能用逐漸落伍的設備,勉強支撐愈來愈複雜的AI應用。
人才和效能都是問題
人才問題更難解決,維護AI伺服器需要熟悉GPU叢集、模型部署、資安、資料治理及MLOps(機器學習維運)的專業團隊。這些人才在科技業待遇優渥,大學能用多少薪水留住他們?如果每所學校都成立自己的AI中心,勢必互相爭奪有限人才。設備可以靠補助購買,專業能力卻無法靠一次性預算建立。
還有一個經常被忽略的問題,就是使用者的期待。AI系統剛啟用時,大家可能覺得新鮮,但使用人數增加後,抱怨也會接踵而來。模型反應太慢、同時使用人數不足、長篇文件處理不了、回答品質不如ChatGPT,甚至連最新功能都沒有。大型語言模型需要大量GPU記憶體,並行使用者增加時,運算需求更會快速上升。學校花了大錢,最後師生卻寧可回頭使用商業AI,豈不尷尬?
發展領域專用AI
台灣真正應該思考的是,能否從各自建置走向同領域共同建置,發展領域專用語言模型(Domain-Specific Language Model)。
例如大學可以由教育部協調,結合國網中心與各校資源,建立全國大學共用的學術AI平台。共同提供基礎模型、運算資源及研究工具,各校則保有自己的資料庫與存取權限。研究資料不必集中到同一個地方,也能透過安全的運算架構共享算力。如此既能降低重複投資,也能讓規模較小的大學享有先進AI服務。
金融業和醫療領域也是如此,大家共同投入模型訓練及維護,再利用自己的內部資料進行檢索增強生成(RAG)或微調。資料仍然各自掌握,競爭敏感資訊不必共享,卻能共同分攤基礎建設成本。
台灣小,資源要整合
政府補助AI建設,也應改變思維。與其鼓勵每個機構提出採購GPU的計畫,不如優先支持具備共同治理、永續營運及跨機構服務能力的方案。評估績效不能只看買了多少張GPU、建了多少座機房,更要看設備使用率、服務品質、單位運算成本,以及實際創造多少研究與產業成果。
AI時代最稀缺的資源,除了算力,還有人才、能源與時間。台灣市場規模有限,電力供應又面臨挑戰,實在沒有本錢讓每個機構都重複建設一套昂貴而容易過時的系統。與其人人擁有一座效能平平的AI機房,不如讓同領域的機構共同擁有一個真正強大的專業AI平台。 台灣需要的不是更多各自為政的AI建設,而是更有智慧的資源整合。
(張瑞雄 台北商業大學榮譽講座教授)